Disaster Recovery: o plano que todo mundo tem e ninguém testou
Ter um plano de recuperação de desastres no papel é fácil. Testá-lo é que assusta.
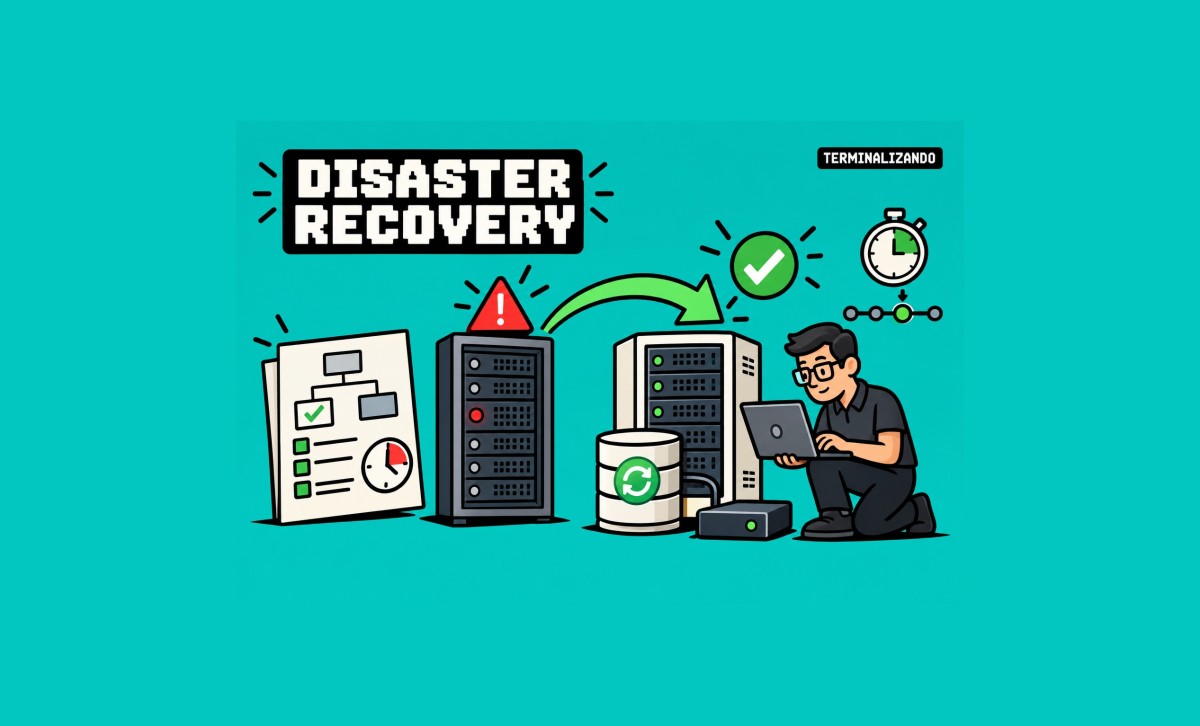
Praticamente toda empresa de médio ou grande porte tem um documento chamado Plano de Disaster Recovery, ou plano de recuperação de desastres. Ele costuma ficar guardado em uma pasta compartilhada, em algum sistema interno ou naquele diretório que ninguém abre há meses.
O problema é que muitos desses planos nunca foram testados de verdade. E existe uma diferença enorme entre ter um documento dizendo que tudo voltará ao normal em duas horas e conseguir fazer isso acontecer quando os servidores param de responder.
Um plano que nunca foi testado é, basicamente, um exercício de otimismo corporativo. Afinal, escrever que a infraestrutura será recuperada rapidamente é fácil. Difícil é cumprir essa promessa quando o banco de dados está fora do ar, o telefone não para de tocar e todo mundo quer saber quando o sistema vai voltar.
Vamos entender por que testar o Disaster Recovery é tão importante quanto planejar a recuperação.
Um plano bonito no papel nem sempre funciona na prática
Um plano de recuperação de desastres bem elaborado pode parecer impecável. Ele tem procedimentos detalhados, contatos atualizados, diagramas de arquitetura, ambientes redundantes e estimativas de tempo para recuperar os serviços.
No papel, tudo funciona perfeitamente.
Os responsáveis estão disponíveis, os acessos funcionam, os backups estão íntegros e todos sabem exatamente o que fazer. Nenhuma dependência foi esquecida e nenhum equipamento resolve apresentar um problema justamente naquele momento.
Na vida real, porém, as coisas costumam ser um pouco diferentes.
Uma credencial pode estar expirada, um servidor pode depender de outro serviço que não foi documentado ou o profissional responsável por determinada etapa pode nem trabalhar mais na empresa.
É por isso que um plano de Disaster Recovery precisa sair do documento e ir para a prática. Os testes permitem encontrar essas falhas antes que elas apareçam no pior momento possível.
RTO e RPO, os dois números que você precisa conhecer
Antes de planejar os testes, é importante entender dois conceitos fundamentais da recuperação de desastres: RTO e RPO.
RTO, Recovery Time Objective
O RTO, ou Objetivo de Tempo de Recuperação, define quanto tempo um serviço pode ficar indisponível antes que os impactos para o negócio se tornem inaceitáveis.
Imagine que o sistema de faturamento de uma empresa tenha um RTO de duas horas. Isso significa que a estratégia de recuperação deve ser capaz de restabelecer o serviço dentro desse período, considerando as condições definidas no plano.
Quanto menor o RTO, mais rápida precisa ser a recuperação. Isso geralmente exige investimentos maiores em redundância, automação e infraestrutura.
RPO, Recovery Point Objective
O RPO, ou Objetivo de Ponto de Recuperação, define a quantidade máxima de dados que a empresa pode perder, medida pelo intervalo de tempo entre o último ponto de recuperação válido e o momento da interrupção.
Imagine que o banco de dados seja protegido por backups ou replicação com um RPO de 30 minutos. Em um cenário de falha, a estratégia deve permitir recuperar os dados até um ponto que limite a perda ao intervalo estabelecido.
É importante lembrar que RPO não significa simplesmente executar um backup a cada 30 minutos. A estratégia precisa garantir que exista um ponto de recuperação utilizável dentro do objetivo definido.
Para visualizar melhor, veja este exemplo:
| Indicador | Objetivo | O que significa |
|---|---|---|
| RTO | 2 horas | O serviço precisa ser recuperado em até 2 horas |
| RPO | 30 minutos | A perda de dados deve ficar limitada a, no máximo, 30 minutos de alterações |
Esses valores precisam refletir a realidade do negócio. Um sistema interno utilizado ocasionalmente pode tolerar algumas horas de indisponibilidade. Já uma plataforma de vendas, um sistema financeiro ou uma aplicação essencial à operação pode exigir uma recuperação muito mais rápida.
Definir esses objetivos sem avaliar os impactos financeiros e operacionais é como escolher o tamanho do extintor sem saber o que pode pegar fogo.
Por que tantas empresas deixam os testes para depois?
Testar um plano de recuperação pode consumir tempo, exigir a participação de várias equipes e envolver riscos operacionais. Em testes mais complexos, uma execução mal planejada pode afetar sistemas que deveriam continuar funcionando normalmente.
Enquanto isso, a equipe de infraestrutura já está ocupada com chamados, atualizações, monitoramento, projetos e os problemas que aparecem sem convite.
Nesse cenário, é fácil adiar o teste para a próxima semana. Depois para o próximo mês. Quando alguém percebe, passou um ano e o plano continua sem ter sido validado.
O problema é que, sem testes, a empresa não sabe se os procedimentos realmente funcionam, se os backups podem ser restaurados ou se o tempo de recuperação previsto é realista.
E existe uma ironia nisso tudo: muitas organizações evitam testar o plano por medo de causar uma interrupção, mas acabam descobrindo suas falhas durante uma interrupção real, quando o risco e o impacto são muito maiores.
A melhor saída é começar com testes controlados e aumentar a complexidade conforme a equipe ganha experiência.
Os diferentes níveis de teste de Disaster Recovery
Nem todo teste precisa desligar um servidor de produção ou transferir toda a operação para outro ambiente. Existem diferentes níveis de validação, cada um com seus próprios objetivos e riscos.
1. Teste de mesa, todo mundo explica o que faria
O teste de mesa, também conhecido como tabletop exercise, é uma simulação em que os responsáveis se reúnem para discutir um cenário de desastre e percorrer as etapas previstas no plano.
Por exemplo, a equipe pode receber a seguinte situação hipotética: o servidor principal do banco de dados sofreu uma falha grave e não pode mais ser utilizado.
A partir daí, os participantes discutem quem deve ser acionado, como o incidente será avaliado, qual ambiente será utilizado na recuperação e como os usuários serão informados.
Nenhuma alteração técnica precisa ser executada. O foco está nos processos, nas responsabilidades e na tomada de decisões.
Esse tipo de exercício ajuda a identificar problemas como contatos desatualizados, responsabilidades mal definidas e dependências esquecidas.
É simples, relativamente barato e um excelente ponto de partida. Só não vale terminar a reunião com a sensação de que tudo foi validado tecnicamente, porque discutir uma restauração não é a mesma coisa que restaurar um servidor.
2. Testes funcionais parciais, colocando a mão na massa
Nesse nível, a equipe executa procedimentos reais de recuperação em um ambiente controlado, sem comprometer os sistemas de produção.
Uma atividade bastante útil é restaurar um backup em um servidor de testes e verificar se os dados estão íntegros, se os serviços iniciam corretamente e se a aplicação consegue utilizar as informações recuperadas.
Outra possibilidade é ativar um ambiente de contingência para confirmar se ele consegue assumir as funções previstas no plano.
Esses testes ajudam a validar componentes específicos da recuperação e podem revelar problemas que não apareceriam durante uma simples revisão da documentação.
Afinal, o backup pode estar listado no sistema, o agendamento pode indicar sucesso e o arquivo pode ocupar vários gigabytes. Nada disso garante, por si só, que a restauração funcionará.
Backup concluído não é sinônimo de recuperação garantida. O que realmente importa é conseguir recuperar os dados e utilizá-los.
3. Teste completo de failover, a prova de fogo
O teste completo de failover é mais rigoroso. Nesse cenário, a organização simula a perda do ambiente principal e transfere as operações para a infraestrutura de recuperação, seguindo os procedimentos definidos.
Dependendo da arquitetura, isso pode envolver a ativação de servidores alternativos, a recuperação de bancos de dados, a mudança de rotas, a atualização de registros DNS e a validação das aplicações pelos usuários.
Esse tipo de teste permite verificar a cadeia de recuperação de ponta a ponta, desde a identificação da falha até a retomada dos serviços.
Por outro lado, exige planejamento cuidadoso, critérios claros de sucesso, responsáveis definidos e um procedimento de retorno ao ambiente original, quando aplicável.
Sempre que possível, deve ser realizado em uma janela controlada, com escopo bem definido e mecanismos para interromper o exercício caso algo saia do previsto.
É o teste mais próximo de uma situação real, mas também aquele que exige maior preparação. Não é recomendável descobrir como funciona o botão de emergência justamente quando a equipe já está correndo para recuperar o ambiente.
O que costuma dar errado durante os testes?
Os testes de Disaster Recovery frequentemente revelam problemas que passaram despercebidos durante meses ou anos.
Backups que não podem ser restaurados
O arquivo existe, o sistema informa que a rotina terminou e os registros parecem normais. Porém, na hora de restaurar, surgem arquivos corrompidos, dados incompletos ou problemas de compatibilidade.
Documentação desatualizada
O plano menciona servidores que foram substituídos, endereços IP que mudaram e procedimentos que já não correspondem à infraestrutura atual.
Dependências esquecidas
Uma aplicação é restaurada, mas não funciona porque depende de um serviço de autenticação, de um banco de dados ou de outro componente que ficou fora do plano.
Credenciais e permissões indisponíveis
A equipe descobre que não possui acesso ao ambiente de contingência ou que as credenciais necessárias estão armazenadas em um sistema inacessível durante o incidente.
Responsáveis que não estão mais na empresa
O documento atribui uma tarefa crítica a alguém que mudou de área ou deixou a organização. Os demais integrantes da equipe nunca foram treinados para assumir aquela responsabilidade.
Tempos de recuperação irreais
O plano promete recuperar um serviço em duas horas, mas o teste demonstra que somente a restauração dos dados leva três horas, sem contar a configuração e a validação da aplicação.
Essas descobertas não significam que o teste falhou. Pelo contrário, significam que ele cumpriu uma de suas funções mais importantes: revelar problemas enquanto ainda existe tempo para corrigi-los.
Automação, uma grande aliada na recuperação
Durante um incidente grave, a pressão aumenta e a possibilidade de erro humano também. Por isso, automatizar procedimentos de recuperação pode melhorar bastante a consistência e a velocidade da resposta.
Scripts testados, ferramentas de orquestração e infraestrutura como código ajudam a executar tarefas de maneira repetível, reduzindo a dependência de intervenções manuais.
Por exemplo, uma infraestrutura descrita em código pode permitir recriar servidores, redes e configurações de forma padronizada. Um procedimento automatizado também pode validar se determinados serviços estão disponíveis antes de liberar o ambiente para os usuários.
Mas existe um detalhe importante: automação não elimina a necessidade de testes.
Um script pode estar desatualizado, depender de uma credencial expirada ou executar uma ação incorreta em grande escala. Automatizar um procedimento errado apenas permite errar mais rápido.
Por isso, scripts, configurações e sequências de recuperação também precisam ser revisados e validados regularmente.
O desastre não precisa começar com um servidor queimado
Quando se fala em recuperação de desastres, muita gente pensa imediatamente em falha de hardware, incêndio ou queda de energia em um data center.
Esses cenários são importantes, mas não são os únicos que precisam ser considerados.
Um plano robusto também deve avaliar situações como:
-
Ataques cibernéticos, incluindo ransomware capaz de comprometer servidores e backups acessíveis pela mesma rede.
-
Desastres físicos, como incêndios, alagamentos e interrupções prolongadas de energia ou conectividade.
-
Falhas de provedores, que podem deixar aplicações indisponíveis mesmo quando os servidores da empresa continuam funcionando.
-
Perda de acesso administrativo, quando credenciais, chaves ou mecanismos de autenticação ficam indisponíveis.
-
Falhas humanas e operacionais, como exclusão acidental de dados, alterações incorretas e mudanças que comprometem serviços essenciais.
No caso de ataques cibernéticos, por exemplo, não basta ter uma cópia dos dados em outro servidor se essa cópia também puder ser apagada ou criptografada pelo mesmo ataque.
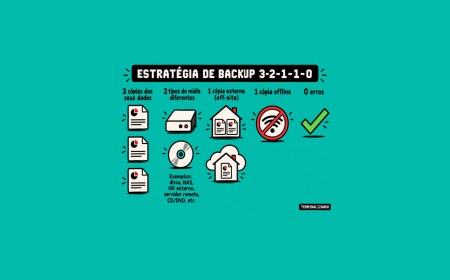
É importante manter cópias protegidas, preferencialmente isoladas ou imutáveis quando apropriado, e testar a recuperação em condições seguras.
O plano também precisa prever como confirmar que o ambiente está limpo e seguro antes de restabelecer os serviços após um incidente de segurança.
Como começar a testar o plano sem complicar tudo
Se a empresa ainda não realiza testes regulares, não é necessário começar com uma simulação que envolva toda a infraestrutura.
Uma abordagem gradual costuma funcionar melhor.
-
Escolha os sistemas prioritários. Identifique quais aplicações provocariam maior impacto financeiro ou operacional se ficassem indisponíveis.
-
Defina RTO e RPO realistas. Estabeleça os objetivos de recuperação considerando as necessidades do negócio, e não apenas o que a infraestrutura consegue entregar atualmente.
-
Revise a documentação. Confirme contatos, responsabilidades, acessos, dependências e procedimentos.
-
Comece com um teste de mesa. Reúna os envolvidos e simule um cenário para identificar lacunas no plano.
-
Teste a restauração dos backups. Recupere dados em um ambiente isolado e valide sua integridade e utilização.
-
Registre os resultados. Anote os tempos reais, os problemas encontrados e as diferenças entre o procedimento documentado e o que aconteceu na prática.
-
Corrija e repita. Defina responsáveis e prazos para resolver as falhas encontradas, depois execute novos testes para confirmar que as correções funcionaram.
A frequência dos testes deve levar em conta a criticidade dos sistemas, as exigências contratuais e regulatórias e a velocidade com que a infraestrutura muda. Também é importante testar novamente após alterações relevantes na arquitetura, nos backups ou nos procedimentos de recuperação.
O objetivo não é produzir um relatório bonito para apresentar à diretoria. É garantir que a empresa consiga recuperar suas operações quando realmente precisar.
Conclusão, o plano precisa funcionar fora do papel
Um Plano de Disaster Recovery não deve ser tratado como um documento criado apenas para cumprir uma exigência de auditoria. Ele precisa representar uma estratégia que a equipe conhece, consegue executar e revisa conforme a infraestrutura evolui.
Os testes permitem descobrir backups inutilizáveis, procedimentos desatualizados, dependências esquecidas e estimativas de recuperação que não correspondem à realidade.
Além disso, ajudam a preparar as pessoas, melhorar a automação e reduzir a incerteza durante situações de crise.
No fim das contas, existe uma diferença enorme entre afirmar que a empresa consegue recuperar seus sistemas e demonstrar que isso realmente funciona.
Porque, quando o desastre acontece, não adianta abrir o documento e descobrir que o responsável pela recuperação saiu da empresa há dois anos, a senha está em um servidor indisponível e o último backup restaurado com sucesso foi feito na época em que tudo ainda funcionava.
Um plano de recuperação só merece confiança depois de ser colocado à prova. E é muito melhor descobrir o que precisa ser corrigido durante um teste planejado do que aprender tudo isso com a operação parada e o telefone tocando sem parar.
Qual é a Sua Reação?
 Curtir
0
 Não Curtir
0
 Amei
0
 Divertido
0
 Uau
0
 Triste
0
 Bravo
0

Oi, eu sou o Misael Reis Analista de TI que trocou o "você já tentou reiniciar?" por respostas um pouco mais sofisticadas (mas nem sempre). Aqui você vai encontrar tudo que aprendo (e às vezes sofro) no dia a dia como sysadmin: Linux, redes, hardening, automações e aquela dose diária de "funciona, mas eu não sei por quê". Sem enrolação, sem PowerPoint corporativo — só terminal, prompt e curiosidade nerd de sobrevivência. Se você também acredita que sudo resolve 90% dos problemas (e o outro 10% é firewall), já é da família. 🐧
Comentários (0)