Logs no Linux: onde a verdade sempre se esconde
Quando algo dá errado, os logs raramente mentem, mas é preciso saber onde procurar.
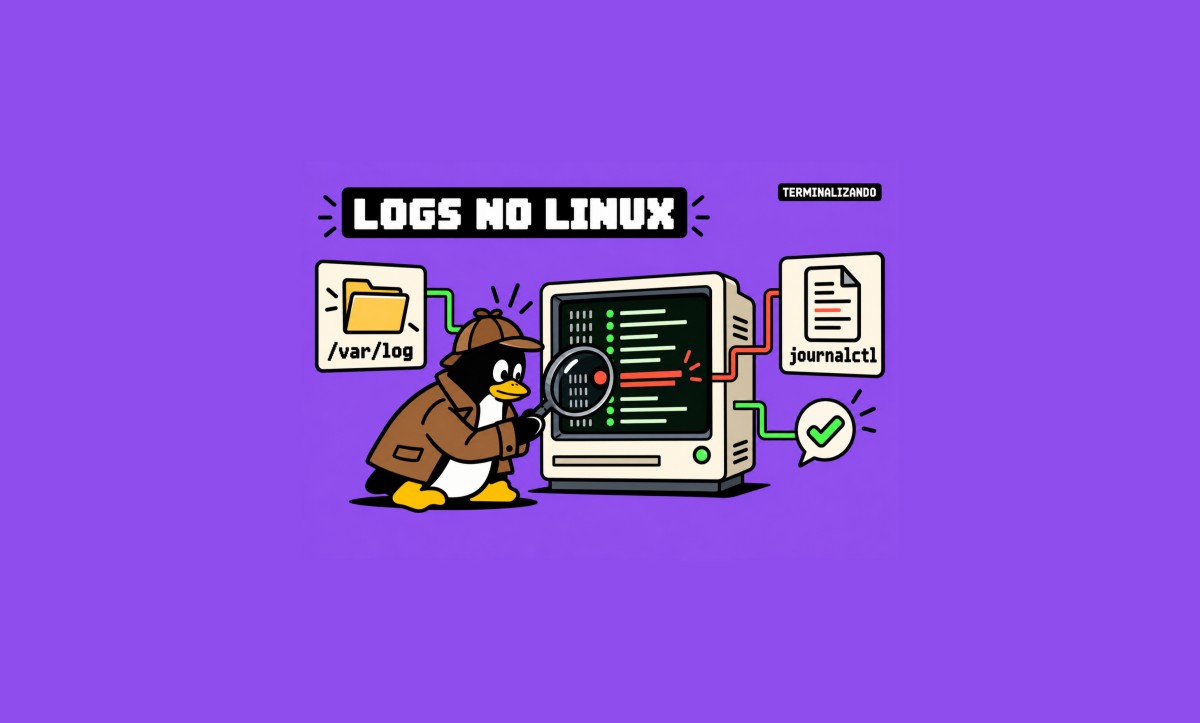
Existe uma regra quase universal no troubleshooting: se você não sabe o que aconteceu, os logs provavelmente sabem.
O problema é que, no Linux, essas informações podem estar espalhadas por diferentes diretórios, arquivos e serviços. Cada aplicação tem seu jeito de registrar eventos, e nem sempre fica claro por onde começar a investigação.
A boa notícia é que você não precisa decorar todos os caminhos e comandos de uma vez. Entendendo onde os principais registros ficam e como filtrá-los, já dá para resolver boa parte dos problemas sem precisar consultar os astros ou reiniciar o servidor na esperança de que ele volte a funcionar por educação.
/var/log: o primeiro lugar para procurar
Tradicionalmente, o diretório /var/log é um dos principais pontos de partida para investigar problemas no Linux.
Dependendo da distribuição e da configuração do sistema, você pode encontrar arquivos como:
| Arquivo | O que costuma registrar |
|---|---|
syslog ou messages |
Mensagens gerais do sistema e de serviços |
auth.log ou secure |
Eventos de autenticação e autorização |
kern.log |
Mensagens relacionadas ao kernel |
Os nomes e a organização variam entre distribuições. Em sistemas baseados em Debian e Ubuntu, por exemplo, é comum encontrar auth.log. Em distribuições da família Red Hat, registros de autenticação costumam aparecer em secure.
Conhecer esses arquivos já ajuda bastante nas primeiras verificações, especialmente quando o problema envolve inicialização, autenticação, serviços ou comportamento do sistema operacional.
journalctl: o caminho central nos sistemas com systemd
Em distribuições que utilizam systemd, o comando journalctl é uma das ferramentas mais importantes para consultar logs.
Ele permite visualizar mensagens de diferentes componentes do sistema em um journal estruturado, com filtros por serviço, período, prioridade e outras propriedades.
Isso facilita bastante a investigação, embora exija conhecer algumas opções próprias do comando. Quem está acostumado a procurar tudo com grep em arquivos de texto vai precisar aprender alguns truques novos.
Consultando os registros de um serviço
Se o problema está relacionado a um serviço específico, não faz muito sentido analisar milhares de mensagens que não têm relação com ele.
Use:
journalctl -u nome-do-servico
Esse comando exibe os registros associados à unidade indicada.
Para acompanhar as mensagens em tempo real, utilize:
journalctl -u nome-do-servico -f
A opção -f funciona de maneira semelhante ao tradicional tail -f, acompanhando novas mensagens conforme elas aparecem. A diferença é que o resultado já vem filtrado para o serviço escolhido.
Filtrando por período
Em uma investigação, saber quando o problema aconteceu é quase tão importante quanto saber onde aconteceu.
Para consultar os registros de uma janela específica:
journalctl --since "2026-09-25 14:00:00" --until "2026-09-25 15:00:00"
Assim, você limita a consulta ao intervalo entre 14h e 15h do dia informado, sem precisar percorrer horas de mensagens que não ajudam na investigação.
Também é possível utilizar períodos relativos:
journalctl --since "1 hour ago"
Esse formato é especialmente útil quando você está acompanhando um incidente em andamento e precisa verificar rapidamente o que aconteceu na última hora.
Os logs das aplicações também contam a história
Nem todo problema aparece nos registros gerais do sistema. Muitas aplicações mantêm seus próprios arquivos de log, normalmente em diretórios específicos.
Servidores web como Nginx e Apache, por exemplo, costumam registrar informações em diretórios como:
/var/log/nginx
/var/log/apache2
Nesses locais, é comum encontrar logs de acesso e de erro. Eles podem mostrar requisições recebidas, códigos de resposta HTTP, endereços de origem e informações úteis para investigar falhas ou lentidão.
Bancos de dados como PostgreSQL e MySQL também possuem registros próprios, que podem ajudar a identificar erros de conexão, consultas problemáticas e questões de desempenho.
A localização exata e o nível de detalhe dependem da configuração de cada serviço. Por isso, quando o problema está claramente associado a uma aplicação, vale consultar também a documentação e as configurações de log dela.
logrotate: evitando que os logs ocupem o disco inteiro
Logs são essenciais, mas também crescem. E, se ninguém cuidar deles, podem consumir todo o espaço disponível em disco.
É aí que entra o logrotate, utilitário responsável por administrar a rotação dos arquivos de log. Conforme as regras configuradas, ele pode arquivar, comprimir e remover registros antigos.
Sem uma política adequada, um arquivo pode crescer indefinidamente até comprometer o funcionamento do sistema ou da aplicação.
E existe uma ironia pouco divertida nesse cenário: os logs que deveriam ajudar a diagnosticar um problema podem acabar provocando outro quando ocupam todo o espaço disponível.
Por isso, além de consultar os registros, é importante verificar se a rotação está configurada corretamente e se os arquivos antigos estão sendo tratados conforme a política da organização.
Quando um arquivo não é suficiente
Alguns incidentes envolvem vários componentes ao mesmo tempo. Uma aplicação apresenta erro, o banco de dados registra uma falha de conexão e, quase no mesmo instante, algum serviço do sistema operacional também reclama.
Nesses casos, acompanhar diferentes fontes de log pode ajudar a entender a sequência dos acontecimentos.
Ferramentas como multitail permitem visualizar múltiplos arquivos em tempo real, facilitando a comparação de eventos que ocorrem em componentes diferentes.
Em ambientes maiores, soluções centralizadas também podem fazer bastante diferença. Plataformas como a ELK Stack, formada por Elasticsearch, Logstash e Kibana, ou Loki com Grafana, permitem reunir registros de vários servidores e aplicações em um ponto central.
Em vez de acessar cada máquina individualmente, a equipe pode pesquisar e correlacionar eventos em um ambiente único. Isso se torna especialmente útil quando a infraestrutura cresce e investigar tudo servidor por servidor deixa de ser uma opção prática.
Níveis de log: nem tudo precisa ser registrado com o mesmo detalhe
Muitas aplicações permitem configurar diferentes níveis de registro, como:
| Nível | Uso comum |
|---|---|
debug |
Informações detalhadas para investigação |
info |
Eventos normais de funcionamento |
warning |
Situações que merecem atenção |
error |
Falhas que impediram uma operação |
critical |
Problemas graves que podem comprometer o serviço |
A escolha do nível adequado depende da aplicação e do ambiente.
Manter o nível debug ativado permanentemente em produção pode gerar um volume enorme de registros, dificultando encontrar as mensagens realmente importantes e aumentando o consumo de armazenamento.
Por outro lado, registrar apenas erros críticos pode eliminar informações de contexto que seriam valiosas para descobrir a causa de uma falha.
O ideal é encontrar um equilíbrio entre detalhamento, desempenho, capacidade de armazenamento e necessidade de investigação.
Atenção aos horários: correlacionar logs depende de relógios corretos
Um detalhe que costuma passar despercebido durante o troubleshooting é a sincronização de horário.
Imagine que uma aplicação registra uma falha às 10h15, mas o banco de dados está com o relógio alguns minutos atrasado. Ao comparar os registros, pode parecer que os eventos aconteceram em uma ordem diferente da real.
Isso complica a identificação da causa raiz, especialmente quando o incidente envolve vários servidores ou equipamentos de rede.
Manter os sistemas sincronizados por meio de NTP ajuda a garantir que os timestamps sejam confiáveis e que os eventos possam ser comparados corretamente.
Em uma investigação, alguns minutos de diferença podem ser suficientes para transformar uma sequência clara de acontecimentos em um quebra-cabeça desnecessário.
Um método simples para começar a investigação
Quando surgir um problema, tente seguir uma sequência lógica:
-
Identifique o componente afetado. O problema está no sistema operacional, em um serviço específico, em uma aplicação ou em uma conexão de rede?
-
Determine o horário aproximado. Saber quando o erro começou ajuda a reduzir o volume de registros.
-
Consulte os logs mais relevantes. Comece pelo journal ou pelos arquivos específicos da aplicação.
-
Filtre as mensagens. Utilize serviço, período e nível de prioridade para reduzir o ruído.
-
Compare eventos relacionados. Verifique se outros componentes registraram algo no mesmo intervalo.
-
Confirme a hipótese antes de alterar configurações. Um log pode apontar uma pista importante, mas é preciso avaliar o contexto antes de concluir que encontrou a causa.
Esse processo evita mudanças precipitadas e ajuda a transformar a investigação em algo mais organizado do que executar comandos aleatórios até o problema desaparecer.
Os logs sabem muita coisa. Aprenda a perguntar.
Dominar os logs do Linux não significa memorizar todos os diretórios, arquivos e parâmetros existentes. Significa desenvolver a capacidade de escolher por onde começar de acordo com o tipo de problema e saber filtrar as informações relevantes.
Antes de assumir que um serviço caiu por falta de memória, que a rede está com problema ou que o sistema resolveu tirar férias, consulte os registros disponíveis.
Eles podem revelar erros, horários, tentativas de autenticação, falhas de dependência e muitos outros detalhes que ajudam a reconstruir o que aconteceu.
No fim das contas, a habilidade não está apenas em saber executar journalctl. Está em fazer a pergunta certa, encontrar a mensagem relevante e interpretar o que ela realmente está dizendo.
Porque, no troubleshooting, reiniciar pode até resolver temporariamente. Mas entender o que aconteceu é o que evita que o mesmo chamado volte para sua fila amanhã.
Qual é a Sua Reação?
 Curtir
0
 Não Curtir
0
 Amei
0
 Divertido
0
 Uau
0
 Triste
0
 Bravo
0

Oi, eu sou o Misael Reis Analista de TI que trocou o "você já tentou reiniciar?" por respostas um pouco mais sofisticadas (mas nem sempre). Aqui você vai encontrar tudo que aprendo (e às vezes sofro) no dia a dia como sysadmin: Linux, redes, hardening, automações e aquela dose diária de "funciona, mas eu não sei por quê". Sem enrolação, sem PowerPoint corporativo — só terminal, prompt e curiosidade nerd de sobrevivência. Se você também acredita que sudo resolve 90% dos problemas (e o outro 10% é firewall), já é da família. 🐧
Comentários (0)