Backup 3-2-1-1-0: por que copiar arquivos não é uma estratégia de backup
Um guia completo sobre a regra 3-2-1-1-0, RPO, RTO, arquitetura resiliente de backup e por que testar a restauração é a parte que ninguém quer fazer, mas precisa.
Existe uma frase recorrente entre profissionais de infraestrutura que resume bem o tema: não existe backup, existe restauração. Copiar arquivos para outro disco, sincronizar uma pasta na nuvem ou tirar um snapshot ocasional pode dar uma sensação confortável de segurança, mas nenhuma dessas ações, isoladamente, garante que os dados poderão ser recuperados no dia em que isso realmente importa, geralmente o pior dia possível.
Por que copiar arquivos não é uma estratégia
Uma cópia simples de arquivos resolve apenas um cenário bem específico: a exclusão acidental recente de um arquivo individual. Ela não protege contra praticamente nenhum outro tipo de incidente relevante:
- Se o ransomware criptografa os dados originais e a cópia está no mesmo disco, na mesma rede ou constantemente conectada ao sistema afetado, a cópia provavelmente também será criptografada junto.
- Se a corrupção de dados acontece silenciosamente, ela pode ser replicada para a cópia antes que alguém perceba qualquer problema.
- Se o hardware onde a cópia está armazenada falha ao mesmo tempo que o equipamento original, por exemplo em um incêndio, enchente ou falha de energia que afeta toda a sala, ambas as cópias podem se perder juntas, no mesmo dia terrível.
Por isso, uma estratégia de backup real precisa considerar múltiplas cópias, em mídias diferentes, com pelo menos uma delas fisicamente ou logicamente isolada do ambiente de produção.
Decifrando a regra 3-2-1-1-0
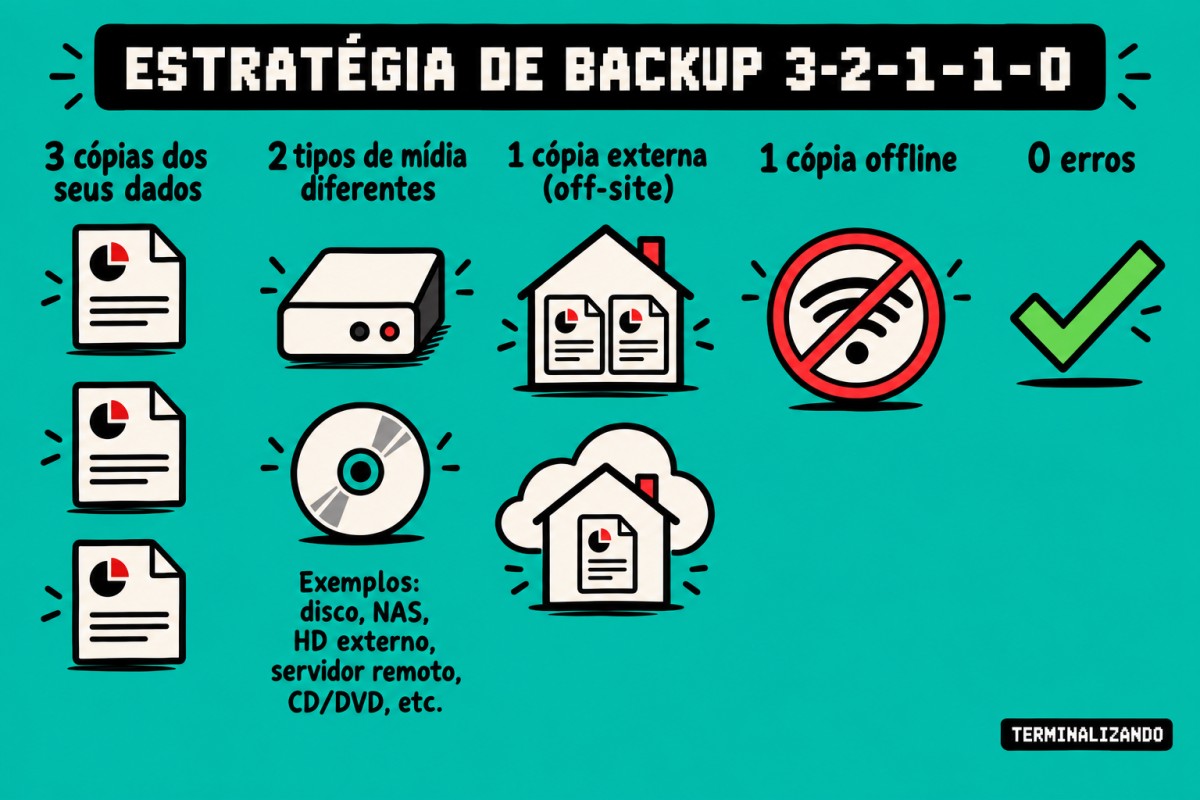
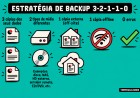
A regra 3-2-1-1-0 é uma evolução da tradicional regra 3-2-1, incorporando lições aprendidas com a ascensão de ataques de ransomware direcionados especificamente a infraestruturas de backup:
- 3 cópias: mantenha ao menos três cópias dos dados, sendo uma delas a cópia de produção em uso ativo.
- 2 mídias diferentes: distribua as cópias em pelo menos dois tipos de armazenamento distintos, como disco local e nuvem, ou disco e fita, reduzindo o risco de uma falha específica de tecnologia afetar todas as cópias de uma vez.
- 1 cópia fora do local: mantenha ao menos uma cópia geograficamente separada do ambiente principal, protegendo contra desastres físicos localizados, como incêndios ou problemas estruturais no data center principal.
- 1 cópia offline ou imutável: mantenha ao menos uma cópia desconectada da rede ou protegida por políticas de imutabilidade, de forma que nenhum processo malicioso em execução no ambiente de produção consiga alcançá-la e corrompê-la ou apagá-la.
- 0 erros: garanta, através de verificação e testes periódicos, que todas as cópias realmente podem ser restauradas sem erros quando necessário.
O último elemento da regra, o zero, é frequentemente o mais negligenciado, e também o mais crítico. Um job de backup pode reportar sucesso todos os dias durante meses e, mesmo assim, estar falhando silenciosamente em incluir uma parte importante dos dados, gerando arquivos corrompidos ou perdendo permissões essenciais, sem que ninguém perceba até o momento em que a restauração real é realmente necessária, momento esse em que descobrir isso é a peor surpresa possível.
Definindo objetivos antes da ferramenta
Antes de escolher qualquer software ou solução de backup, é fundamental definir dois parâmetros que orientam toda a estratégia:
- RPO (Recovery Point Objective): a quantidade máxima aceitável de dados que a organização está disposta a perder, medida em tempo. Um RPO de quatro horas significa que, no pior caso, é aceitável perder até quatro horas de dados desde o último backup válido.
- RTO (Recovery Time Objective): o tempo máximo aceitável para restaurar completamente um serviço após um incidente. Um RTO de duas horas significa que o serviço precisa estar novamente disponível dentro desse intervalo após o início da restauração.
Esses dois números determinam praticamente todas as decisões técnicas subsequentes: frequência dos backups, tecnologia de armazenamento necessária, largura de banda exigida para transferência e até o orçamento necessário para a solução escolhida. Um banco de dados transacional crítico provavelmente exige um RPO medido em minutos, enquanto um repositório de documentos estáticos convive tranquilamente com um RPO de vinte e quatro horas.
Desenhando uma arquitetura de backup realista
Um exemplo de arquitetura aplicando a regra 3-2-1-1-0 para um servidor de arquivos corporativo poderia ser estruturado assim:
Cópia 1: dados em produção no servidor de arquivos
Cópia 2: backup local em storage dedicado, para restaurações rápidas do dia a dia
Cópia 3: réplica enviada para um provedor de nuvem em outra região geográfica
Isolamento: retenção imutável configurada no provedor de nuvem, impedindo exclusão
           ou alteração antes de um período mínimo definido
Esse desenho garante que, mesmo em caso de um ataque de ransomware bem-sucedido no ambiente de produção e no storage local, a cópia em nuvem, protegida por imutabilidade, permaneça intacta e disponível para restauração, funcionando como aquele plano B que ninguém esperava precisar, mas todo mundo agradece quando existe.
O que deve constar em um plano de backup formal
- Inventário completo de sistemas, volumes de dados e nível de criticidade de cada um, permitindo priorizar recursos onde realmente importa.
- Política de retenção, definindo por quanto tempo cada tipo de backup deve ser mantido antes de ser descartado.
- Controles de criptografia e acesso, garantindo que os backups em si não se tornem um vetor de exposição de dados sensíveis.
- Monitoramento ativo da execução dos jobs, incluindo alertas automáticos em caso de falha, atraso ou consumo anormal de capacidade.
- Procedimentos documentados de restauração, detalhados o suficiente para serem seguidos por qualquer pessoa da equipe, mesmo sob a pressão de um incidente real.
- Calendário de testes periódicos de restauração, incluindo testes completos de recuperação de desastre, não apenas testes pontuais de arquivos isolados.
O teste de restauração que ninguém quer fazer, mas precisa
É extremamente comum que equipes configurem backups com cuidado, monitorem sua execução diária, e nunca realmente testem uma restauração completa até o dia em que um incidente real acontece. Esse é exatamente o momento errado para descobrir que o processo de restauração é mais lento do que o RTO definido, que uma dependência crítica ficou de fora do backup, ou que a documentação do procedimento está desatualizada há dois anos.
A prática recomendada é agendar testes periódicos de restauração, variando o escopo entre:
- Restauração de arquivos individuais, validando o processo mais simples e frequente.
- Restauração completa de uma máquina virtual ou servidor específico em um ambiente isolado de testes.
- Restauração de um banco de dados completo, incluindo validação de integridade dos dados recuperados.
- Simulação de um cenário completo de disaster recovery, envolvendo múltiplos sistemas dependentes entre si.
Registrar o tempo real necessário para cada tipo de teste é essencial para confirmar, na prática e não só na teoria, se o RTO definido no papel é realmente alcançável com a infraestrutura atual.
Perguntas frequentes
Sincronização em nuvem, como um serviço de armazenamento pessoal, conta como backup?
Não, se for a única cópia existente. Serviços de sincronização replicam alterações quase em tempo real, o que significa que a exclusão ou corrupção de um arquivo também será sincronizada rapidamente, sem deixar uma versão anterior isolada e protegida.
Backup em nuvem elimina a necessidade de backup local?
Não necessariamente. Backup em nuvem resolve o requisito de cópia fora do local, mas a velocidade de restauração a partir de uma cópia local costuma ser bem maior, o que importa quando o RTO definido é curto.
Com que frequência os testes de restauração devem ser realizados?
Depende da criticidade do sistema, mas uma prática comum é realizar testes simples mensalmente e testes completos de disaster recovery ao menos semestralmente, ou após qualquer mudança relevante de infraestrutura.
Conclusão
Uma estratégia de backup madura não se mede pela quantidade de cópias existentes, mas pela confiança real de que qualquer uma delas pode ser restaurada dentro do tempo que o negócio exige. A regra 3-2-1-1-0 oferece um framework sólido para estruturar essa estratégia, mas o elemento decisivo continua sendo o teste periódico e disciplinado de restauração, feito antes que o incidente decida testar por você.
Regra de ouro: um backup só existe de fato quando a restauração já foi testada com sucesso, dentro do tempo que a operação do negócio realmente pode tolerar.
Qual é a Sua Reação?
 Curtir
0
 Não Curtir
0
 Amei
0
 Divertido
0
 Uau
0
 Triste
0
 Bravo
0

Oi, eu sou o Misael Reis Analista de TI que trocou o "você já tentou reiniciar?" por respostas um pouco mais sofisticadas (mas nem sempre). Aqui você vai encontrar tudo que aprendo (e às vezes sofro) no dia a dia como sysadmin: Linux, redes, hardening, automações e aquela dose diária de "funciona, mas eu não sei por quê". Sem enrolação, sem PowerPoint corporativo — só terminal, prompt e curiosidade nerd de sobrevivência. Se você também acredita que sudo resolve 90% dos problemas (e o outro 10% é firewall), já é da família. 🐧
Comentários (0)